Sudah pukul 2:47 pagi. Telefon anda berdengung dengan amaran pemantauan: salah satu daripada tiga cakera dalam tatasusunan pelayan pengeluaran anda telah tercicir di luar talian. Jika pelayan itu menjalankan persediaan cakera tunggal biasa, anda kini terjaga dan memandu ke pejabat. Tetapi jika ia menjalankan tatasusunan RAID perisian yang dikonfigurasikan dengan betul, anda melihat amaran, berguling dan tidur sehingga pagi — kerana data masih dihidangkan daripada cermin yang masih hidup, dan anda mempunyai pelan pemulihan yang telah dilatih dengan baik.
Itulah janji senyap RAID: bukan bahawa cakera tidak akan gagal, tetapi kegagalan tunggal menjadi kesulitan dan bukannya malapetaka. Dan pada Linux, alat yang menjadikan janji ini nyata ialah `mdadm` — utiliti pentadbiran berbilang peranti yang menguruskan subsistem RAID perisian terbina dalam kernel. Dalam panduan ini, kami akan membina tatasusunan dari awal, menyediakan pemantauan yang menangkap masalah lebih awal dan meneruskan pemulihan cakera yang gagal langkah demi langkah.
Mengapa Software RAID Masih Penting pada 2026
Sistem fail moden seperti ZFS dan Btrfs menawarkan lebihan mereka sendiri, dan pengawal RAID perkakasan masih biasa dalam storan perusahaan. Jadi mengapa perlu bersusah payah dengan `mdadm`? Tiga sebab.
Pertama, ia sudah ada. Perisian RAID adalah sebahagian daripada kernel Linux. Tiada pemacu untuk dipasang, tiada firmware vendor untuk dikemas kini, tiada kad RAID yang gagal. Tatasusunan hidup pada cakera itu sendiri, jadi anda boleh memindahkan semua cakera ke mesin yang sama sekali berbeza dan kernel akan dengan senang hati memasang semula tatasusunan.
Kedua, tiada kunci masuk vendor. Pengawal RAID perkakasan yang mati boleh membawa data anda bersamanya jika anda tidak dapat mendapatkan penggantian yang serupa. Perisian RAID mudah alih merentasi mana-mana sistem Linux dengan kernel moden.
Ketiga, ia telus dan boleh skrip. Setiap operasi ialah perintah yang anda boleh automasi, log dan audit. Tiada GUI pengurusan legap yang menyembunyikan apa yang sebenarnya berlaku.
Di mana RAID perkakasan masih menang ialah cache tulis bersandarkan bateri dan memunggah pengiraan pariti daripada CPU. Untuk sebahagian besar penggunaan bersaiz kecil dan sederhana — pelayan fail, hos pangkalan data, nod virtualisasi homelab — perisian RAID adalah lebih daripada mencukupi, dan CPU berbilang teras hari ini hampir tidak menyedari matematik pariti.
Tahap RAID Yang Sebenarnya Penting
Anda akan menghadapi banyak peringkat RAID, tetapi dalam amalan lima daripadanya merangkumi hampir setiap senario dunia sebenar. Inilah cara mereka membandingkan.
| Tahap | Lebihan | Cakera Min | Kapasiti Boleh Digunakan | Terbaik Untuk |
|---|---|---|---|---|
| SERBU 0 | Tiada | 2 | 100% | Ruang calar, data suhu, prestasi |
| SERBUAN 1 | Cermin | 2 | 50% | Kelantangan but, pangkalan data kecil |
| SERBUAN 5 | pariti tunggal | 3 | (N-1) cakera | Penyimpanan fail tujuan umum |
| SERBUAN 6 | Dwi pariti | 4 | (N-2) cakera | Tatasusunan besar yang berisiko membina semula tinggi |
| SERBUAN 10 | Cermin + jalur | 4 | 50% | Pangkalan data, prestasi penulisan tinggi |
RAID 0 menjalur data merentas cakera tanpa redundansi sama sekali. Ia pantas dan menggunakan kapasiti penuh, tetapi jika mana-mana cakera mati, anda kehilangan segala-galanya. Jangan sekali-kali menggunakannya untuk data yang anda sayangi.
RAID 1 mencerminkan data merentas dua (atau lebih) cakera. Ia adalah model redundansi yang paling mudah: setiap tulis pergi ke kedua-dua cakera, dan bacaan boleh datang dari salah satu. Anda membayar 50% daripada kapasiti anda untuk ketenangan fikiran.
RAID 5 menjaringkan data ditambah satu blok pariti teragih merentasi sekurang-kurangnya tiga cakera. Anda kehilangan kapasiti satu cakera kepada pariti tetapi terselamat daripada satu kegagalan cakera. Ia adalah jalan tengah yang popular — walaupun sedar bahawa semasa pembinaan semula, kegagalan kedua membawa maut, dan cakera perlahan yang besar mengambil masa yang lama untuk dibina semula.
RAID 6 menambah blok pariti kedua, jadi ia bertahan dua kegagalan cakera serentak. Ini penting pada tatasusunan besar cakera besar, di mana pembinaan semula boleh menjangkau beberapa jam.
RAID 10 menggabungkan pencerminan dan jaluran. Ia adalah pilihan terpantas untuk beban kerja berat tulis seperti pangkalan data, dengan kos 50% kapasiti boleh guna. Jika prestasi dan kebolehpercayaan kedua-dua perkara dan belanjawan membenarkan, RAID 10 ialah pilihan klasik.
Untuk kebanyakan pelayan tujuan umum, RAID 1 untuk OS dan RAID 5 atau 6 untuk data ialah garis dasar yang wajar. Untuk pelayan pangkalan data, condong ke arah RAID 10.
Membina Tatasusunan mdadm Pertama Anda
Marilah kita membina tatasusunan RAID 5 tiga cakera dari awal. Saya akan menganggap tiga cakera baharu: `/dev/sdb`, `/dev/sdc` dan `/dev/sdd`.
Langkah 1 — Kenal pasti cakera anda. Sebelum menyentuh apa-apa, sahkan dengan tepat peranti yang anda gunakan. Mendapat kesilapan ini ialah cara orang memadam cakera yang salah.
```bash
lsblk -o NAMA,SAIZ,JENIS,MODEL
sudo fdisk -l
```
Langkah 2 — Bahagikan cakera. Anda boleh menggunakan keseluruhan cakera, tetapi pembahagian dengan jenis yang betul menandakannya dengan jelas sebagai ahli RAID. Cipta satu partition jenis `fd` (Linux raid autodetect) pada setiap cakera menggunakan `parted` atau `sfdisk`.
```bash
sudo parted /dev/sdb --script mklabel gpt mkpart primary 1MiB 100%
sudo parted /dev/sdb --script set 1 raid on
```
Ulang untuk `/dev/sdc` dan `/dev/sdd`. Matlamatnya ialah susun atur partition yang bersih di mana setiap cakera ahli sepadan.
Langkah 3 — Buat tatasusunan. Ini adalah saat komitmen. Gunakan `--level=5`, senaraikan setiap peranti dan sahkan kiraan cakera.
```bash
sudo mdadm --create /dev/md0 --level=5 --raid-devices=3 /dev/sdb1 /dev/sdc1 /dev/sdd1
```
Inti segera memulakan penyegerakan semula awal, membina pariti dari awal. Pada cakera besar ini boleh mengambil masa berjam-jam. Anda boleh menggunakan tatasusunan semasa ia menyegerak, tetapi prestasi akan dikurangkan.
Langkah 4 — Tonton penyegerakan awal. Fail tunggal yang paling berguna dalam semua RAID perisian ialah `/proc/mdstat`. Ia menunjukkan status tatasusunan, cakera mana yang aktif, dan kemajuan penyegerakan semula.
```bash
tonton -n 5 cat /proc/mdstat
```
Apabila penyegerakan semula selesai, tatasusunan melaporkan `[UUU]` — tiga ahli yang sihat.
Langkah 5 — Buat sistem fail dan lekapkannya. Peranti tatasusunan (`/dev/md0`) berkelakuan sama seperti peranti blok biasa.
```bash
sudo mkfs.ext4 /dev/md0
sudo mkdir -p /mnt/data
sudo mount /dev/md0 /mnt/data
```
Langkah 6 — Simpan konfigurasi tatasusunan. Ini ialah langkah yang orang lupakan, dan kosnya tinggi selepas but semula. Anda mesti mengekalkan definisi tatasusunan supaya kernel memasangnya semula secara automatik.
```bash
sudo mdadm --detail --scan | sudo tee -a /etc/mdadm/mdadm.conf
sudo kemas kini-initramfs -u
```
Langkah 7 — Tambahkannya pada `/etc/fstab`. Gunakan UUID sistem fail, bukan nama peranti, supaya pelekap itu kekal dalam susunan semula cakera.
```bash
sudo blkid /dev/md0
```
Kemudian tambah satu baris pada `/etc/fstab` merujuk `UUID=
Itu sahaja - tatasusunan yang berdaya tahan, dipasang secara automatik pada setiap but.
Pemantauan: Menangkap Susunan Yang Didegradasi Sebelum Menggigit
Tatasusunan RAID yang tidak dipantau adalah rasa keselamatan yang palsu. Intinya ialah mengetahui segera apabila cakera gagal, bukan minggu kemudian apabila cakera kedua hilang.
Pandangan harian. `/proc/mdstat` dan `mdadm --detail` ialah persinggahan pertama anda.
```bash
kucing /proc/mdstat
sudo mdadm --detail /dev/md0
```
Lihat ringkasan keadaan: `[UUU]` sihat, `[UU_]` bermakna seorang ahli hilang. Dalam output `--detail`, tonton baris `State` dan kiraan `Failed Devices`.
Kesihatan cakera proaktif. RAID memberitahu anda apabila cakera telah sudah gagal. SMART memberitahu anda apabila ia hampir. Pasang `smartmontools` dan dayakan ujian kendiri latar belakang.
```bash
sudo smartctl -a /dev/sdb
sudo smartctl -t pendek /dev/sdb
```
Perhatikan terutamanya kiraan sektor yang diperuntukkan semula, sektor yang belum selesai dan kiraan ralat UDMA CRC yang semakin meningkat (selalunya kabel yang gagal).
Makluman e-mel automatik. `mdadm` dihantar dengan mod monitor yang memantau tatasusunan dan menghantar e-mel kepada anda mengenai sebarang perubahan keadaan. Konfigurasikan alamat destinasi dalam `/etc/mdadm/mdadm.conf` dan dayakan perkhidmatan `mdmonitor` systemd.
```bash
grep MAILADDR /etc/mdadm/mdadm.conf
sudo systemctl enable --now mdmonitor
```
Integrasi dengan pemantauan moden. Jika anda menjalankan Prometheus, `nodeexporter` mendedahkan metrik RAID daripada `/proc/mdstat` melalui pengumpul mdnya, jadi anda boleh memberi amaran apabila cakera ahli melaporkan keadaan gagal. Pengguna Nagios boleh menggunakan pemalam `checkraid` untuk tujuan yang sama.
Memulihkan Cakera Gagal
Ini adalah prosedur yang anda latih supaya anda boleh melaksanakannya dengan tenang pada jam 2 pagi. Katakan `/dev/sdb1` telah gagal dan tatasusunan kini melaporkan `[U_U]`.
Langkah 1 — Sahkan kegagalan.
```bash
kucing /proc/mdstat
sudo mdadm --detail /dev/md0
```
Langkah 2 — Tandai cakera sebagai gagal dan keluarkannya. Ini memberitahu kernel untuk berhenti bergantung padanya.
```bash
sudo mdadm /dev/md0 --fail /dev/sdb1
sudo mdadm /dev/md0 --remove /dev/sdb1
```
Langkah 3 — Gantikan cakera fizikal. Matikan jika cakera tidak boleh tukar panas, atau tukar secara langsung jika perkakasan anda menyokongnya.
Langkah 4 — Sediakan cakera baharu secara serupa. Bahagikannya dengan reka letak dan jenis RAID yang sama seperti yang asal.
```bash
sudo parted /dev/sdb --script mklabel gpt mkpart primary 1MiB 100%
sudo parted /dev/sdb --script set 1 raid on
```
Langkah 5 — Tambah cakera kembali ke tatasusunan. Kernel mula membina semula serta-merta, menyalin data daripada ahli yang masih hidup.
```bash
sudo mdadm /dev/md0 --add /dev/sdb1
tonton -n 5 cat /proc/mdstat
```
Langkah 6 — Kemas kini konfigurasi yang disimpan supaya identiti cakera baharu direkodkan, kemudian sahkan tatasusunan kembali ke `[UUU]`.
```bash
sudo mdadm --detail --scan | sudo tee /etc/mdadm/mdadm.conf
```
Dua perangkap penting. Pertama, cakera gantian mestilah sekurang-kurangnya sama besar dengan ahli sedia ada terkecil — cakera yang lebih kecil ditolak. Kedua, jika tatasusunan anda tidak mempunyai bitmap niat tulis, keseluruhan tatasusunan mesti disegerakkan semula sepenuhnya walaupun hanya sebahagian daripadanya berubah. Menambah peta bit dalaman menjadikan pembinaan semula masa hadapan dengan lebih pantas.
```bash
sudo mdadm --grow /dev/md0 --bitmap=internal
```
Petua dan Amalan Terbaik Pro
RAID bukan sandaran. Ini tidak boleh dilebih-lebihkan. RAID melindungi daripada kegagalan cakera — ia tidak melakukan apa-apa terhadap pemadaman tidak sengaja, perisian tebusan, sistem fail yang rosak atau peristiwa kuasa yang menggoreng seluruh mesin. Simpan sandaran sebenar menggunakan peraturan 3-2-1: tiga salinan, dua jenis media, satu di luar tapak. Alat seperti `rsync`, Borg dan restic (dirangkum dalam catatan awal di blog ini) termasuk dalam setiap penggunaan yang serius.
Gunakan peta bit niat tulis untuk membuat binaan semula dengan pantas, seperti yang ditunjukkan di atas.
Jadualkan scrub data bulanan. Scrub membaca setiap blok dan mengesahkan pariti, menangkap rasuah senyap sebelum ia menjadi kehilangan data.
```bash
semak gema | sudo tee /sys/block/md0/md/sync_action
```
Pantau SMART, bukan sahaja keadaan RAID. Cakera yang masih "dalam tatasusunan" tetapi mengumpul sektor yang diperuntukkan semula ialah jam yang berdetik. Gantikannya secara proaktif.
Simpan cakera yang sama jika boleh. Saiz pencampuran membazir kapasiti, dan model pencampuran boleh mencipta ketidakpadanan prestasi yang halus. Simpan alat ganti sejuk di atas rak.
Uji pemulihan anda. Sandaran yang belum diuji dan prosedur pembinaan semula yang belum dilatih adalah tidak bernilai. Berlatih untuk gagal dan menambah semula cakera dalam persekitaran makmal supaya perkara sebenar terasa rutin.
Intinya
Software RAID ialah salah satu teknologi yang memberi ganjaran kepada pelaburan awal yang kecil dengan ketenangan fikiran yang sangat besar. Dengan `mdadm`, tatasusunan tiga cakera yang sederhana menukar kegagalan cakera bencana kepada tugas penyelenggaraan rutin: tukar cakera, tambahkannya semula dan biarkan kernel melakukan yang lain. Binanya dengan sengaja, pantaunya tanpa henti, dan latih pemulihan sebelum anda memerlukannya.
Pengendali pintar tidak berharap cakera mereka tidak pernah gagal — mereka merancang untuk hari yang pertama.
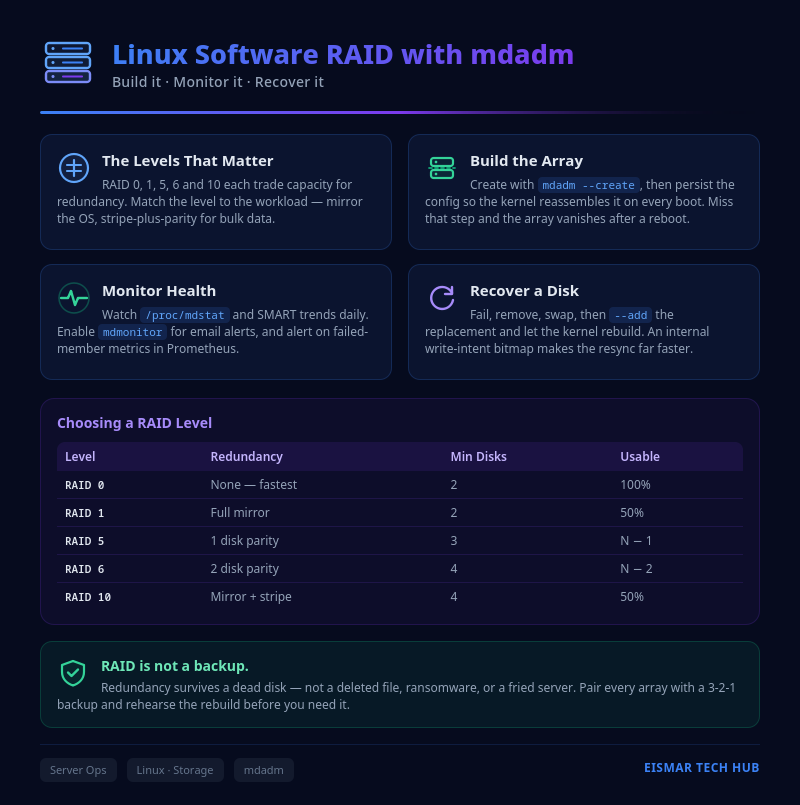
Infografik: Linux Software RAID dengan mdadm
💬 0 Comments